

金色财经报道,Blockworks Advisory 最新研究显示,全球算力基建投入已达数万亿美元,但算力需求仍超过供给。在此背景下,加密 AI 推理赛道正尝试以分布式 GPU、代币激励、隐私与无审查模型、稳定币支付等路径切入市场。不过,从规模看,加密 AI 板块全部可流通总市值仅约 249 亿美元,低于 Crusoe 一家企业的 309 亿美元;且尚无去中心化算力网络公开核实营收达到数千万美元以上。
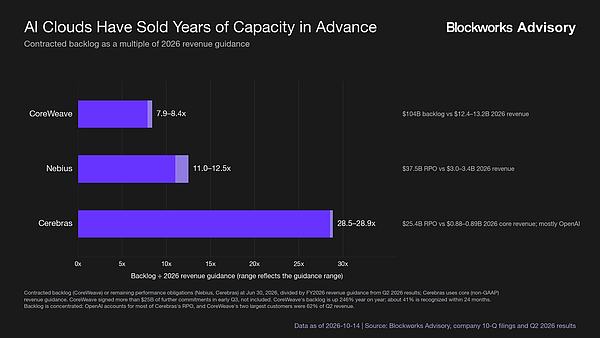
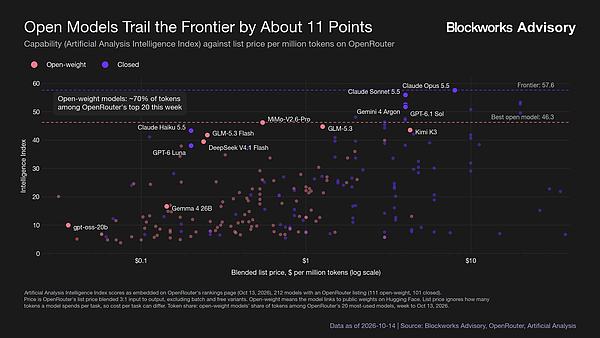
与此同时,开源权重模型性能持续逼近前沿闭源模型,绝大多数模型在大量任务中已“够用”,开发者可将高成本任务调度至更快、更便宜的算力资源,实现降本增效。
推理服务商处于技术栈核心
推理服务商层处于整套技术栈的核心位置。表面看,该市场与传统 API 市场逻辑一致:向指定模型提交提示词,获取输出结果,按 Token 计费或订阅制付费。加密原生服务商的差异化路径主要包括:依托分布式 GPU 获取算力,如 AkashML、Chutes;利用代币激励启动供给端;依托适配特定模型类型的硬件,如使用 Mac 设备的 Darkbloom;支持稳定币支付及 x402 协议;提供隐私保障或无审查模型,如 Venice、NEAR AI;借助代币撬动需求、冷启动用户。
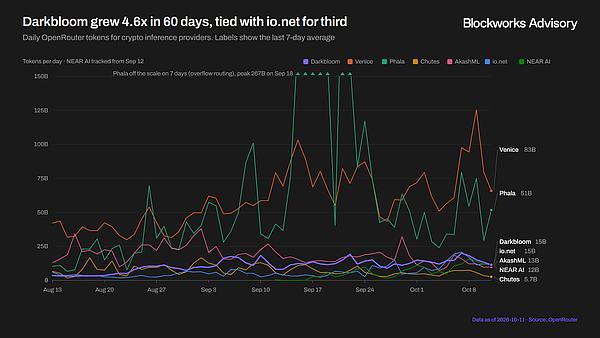
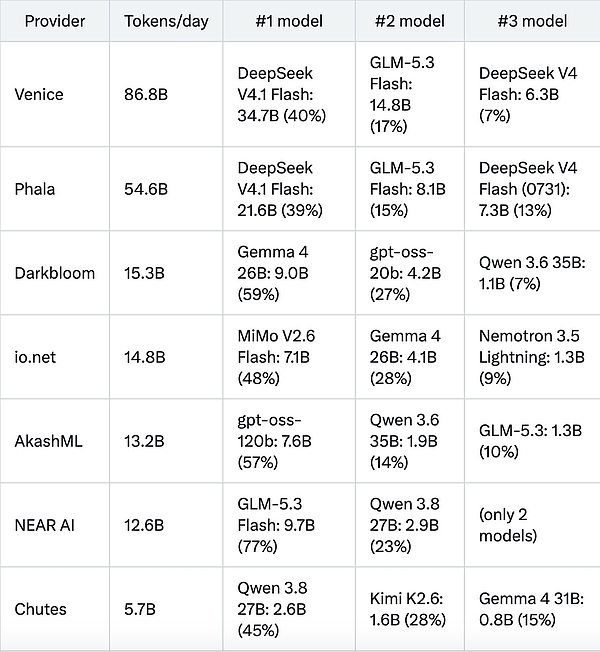
目前尚不确定这些差异化路径能否构筑长期护城河。多家原生加密厂商已推出隐私型、无审查模型,多数项目也会以代币机制扩张网络规模。此外,加密赛道整体市场占比很小。OpenRouter 平台上的 7 家加密原生服务商——Venice、Phala、Darkbloom、io.net、AkashML、NEAR AI、Chutes——过去一个月日均处理约 2110 亿 Token,仅占该平台日均 21.9 万亿 Token 总量的 1%。
OpenRouter 本身只承载全球需求的一部分。谷歌在 2025 年 10 月披露,单月处理约 1.3 千万亿 Token,约为当前 OpenRouter 总流量的两倍;另有估算显示,全球每日 Token 调用量约 400 万亿。但 OpenRouter 每日发布分服务商、分模型统计数据,因此成为对比加密原生推理服务商的中立观测窗口。
竞品格局:Venice 与 Phala 位居前列
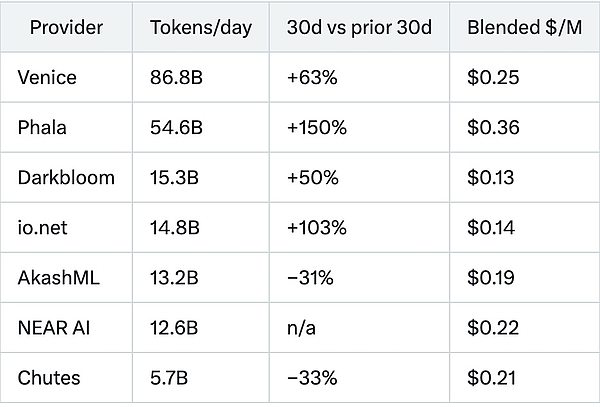
从 Token 调用量看,在 OpenRouter 的加密原生服务商榜单中,Venice 与 Phala 位居前列;其中 Phala 的综合单 Token 定价基于可信执行环境 TEE,为最高。服务商同样在上新速度、模型规模、隐私保障层面竞争。Venice 与 Phala 的模型集存在大量重合,其余竞品侧重提供小型模型,自然产生的 Token 消耗量更低。
Venice:商业化表现最突出
Venice 是这批服务商中商业化表现最突出的一家。对 Venice 而言,OpenRouter 属于低收益渠道,主要用来扩大曝光与业务体量;高毛利收入来自自有 App,App 端单 Token 定价更高。Venice 的隐私专属层级也会转售算力,算力采购自 NEAR AI 与 Phala。
其核心优势在于丰富的产品矩阵及面向 C 端消费的品牌,而非某一款独家模型。Venice 模型库包含约 400 款模型,覆盖文本、图像、视频、音乐、语音;平台同时上线 Claude Fable 5.1、Grok 4.6 等闭源前沿模型与开源模型,全部遵循无日志留存承诺。近期迭代新增 AI 智能体对话、视频剪辑、加密聊天备份功能。
在 OpenRouter 平台,Venice 是规模最大的加密原生服务商,日均处理约 870 亿 Token。OpenRouter 贡献的营收占其总营收不到 10%。团队 7 月公开披露年化 ARR 达 1 亿美元。OpenRouter 作为低收益渠道负责放量,高毛利收入来源于自有 App。Venice 的隐私硬件算力层级,向 NEAR AI 采购的价格为官方标价上浮 7%,向 Phala 采购则在标价基础上加价约 25%。
Chutes:Bittensor 生态推理子网
Chutes 是 Bittensor 生态的推理子网(SN64),运行约 4350 张 GPU,其中半数为 H200;目前所有节点都必须部署在 Intel TDX 机密虚拟机内。大部分业务流量来自自有 API 与订阅服务,而非 OpenRouter。
Chutes 团队对外宣称全网日处理 1600 亿 Token,其中 OpenRouter 端流量为每日 57 亿 Token。Chutes 推理定价低于同行,在 OpenRouter 上架的每一款模型中,其报价均位列最便宜的三家服务商之列。
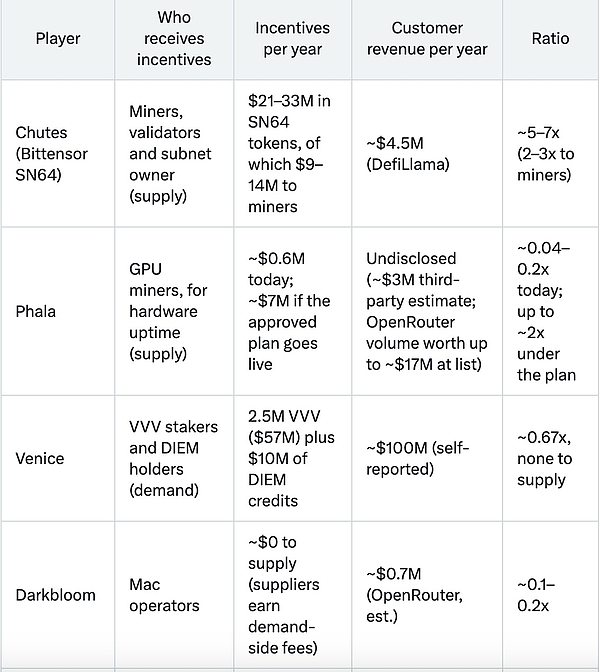
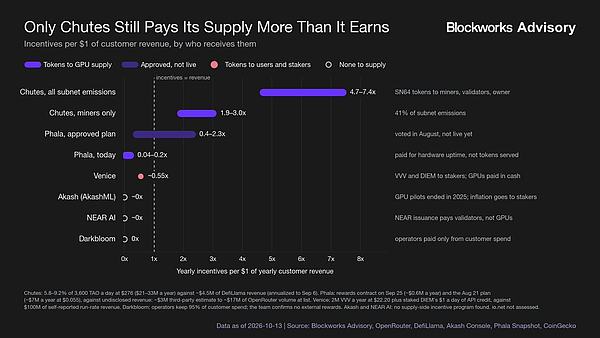
低价很大一部分由网络代币补贴支撑。当前该子网获取 Bittensor 代币总释放量的 6%—9%,TAO 单价 276 美元,折算子网每年代币补贴规模 2100 万—3300 万美元,全部以原生代币发放,其中 41% 分配给矿工。DefiLlama 统计其链上年收入约 450 万美元,代币释放补贴约为链上实际收入的 5—7 倍;仅矿工分得部分,就达到实际收入的 2—3 倍。
AkashML:历史最久的 GPU 交易市场
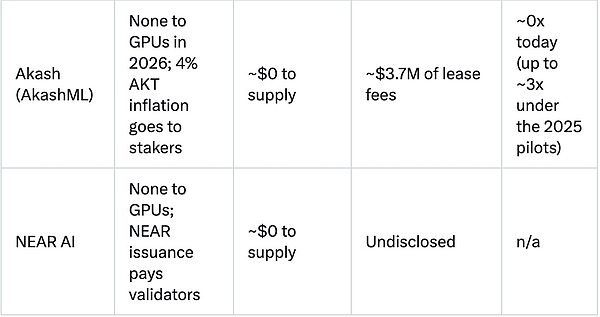
Akash 是这批项目中历史最久的 GPU 交易市场。当前活跃 GPU 共 283 张,峰值时期曾达到 897 张,年度租赁服务费 370 万美元。旗下推理服务 AkashML,是 Darkbloom 在 OpenRouter 平台最直接的竞争对手。
2026 年该网络没有运行 GPU 激励计划;Akash 在 2025 年末将 160 万枚未使用的 AKT 激励代币返还社区资金池。AKT 每年 4% 通胀产出全部分配给质押者,而非 GPU 算力提供者。自 3 月起,用户每一笔付费都会回购并销毁 AKT,算力提供者收到等额法币价值回报;网络只是流转用户付费,不会额外增发代币补贴。
Phala:机密云与算力路由
Phala 基于 Intel TDX 与英伟达机密计算 GPU 搭建机密云,同时开源开发 dstack 机密计算运行时,NEAR AI 同样基于该组件运行。它是 OpenRouter 上第二大加密原生服务商,过去一周日均处理 546 亿 Token,7 月时仅为每日 50 亿 Token。
Phala 既是 GPU 算力运营商,同时也扮演机密算力路由角色。其网关会对外公示每一个模型实际调用的上游服务商。根据公开清单,上周 OpenRouter 的大部分流量实际跑在第三方硬件之上:约三分之一流量来自 Chutes 的机密硬件;15% 来自 NEAR AI;40% 流量全部为 DeepSeek V4.1 Flash,经由 RedPill 路由,不使用机密硬件。
9 月,约半数流量运行在 Phala 自身的可信执行环境。当时运行在自有硬件上体量最大的模型 GLM-5.3,现已显示由 Tinfoil 提供服务。Phala 转售第三方模型的定价等于或高于上游供应商,例如 Kimi K3,Phala 平台价格比 Chutes 高出约 35%。
Phala 并未对外披露营收。按照官方标价,不计缓存折扣、不计向上游供应商支付成本,其 OpenRouter 流量对应的理论年化收入最高约 1700 万美元。代币层面,9 月末 Phala 的 GPU 挖矿奖励年化约 60 万美元,奖励依据硬件规格与在线时长结算,与实际调用量无关。8 月代币持有者投票决议,将剩余 1.6 亿枚 PHA 在 15 个月内加速释放,按现价折合每年约 700 万美元。
io.net:从 Solana 生态 GPU 市场走向推理
io.net 最初是 Solana 生态 GPU 交易市场,如今在 OpenRouter 对外销售推理算力。过去一个月,其 Token 调用量几乎翻倍,达到每日 148 亿 Token,与 Darkbloom 持平;在 7 家服务商中,它的单 Token 价格为倒数第二低。
Gemma 4 26B 是 io.net 调用量第二大的模型,同时也是 Darkbloom 的头部模型,这让 io.net 成为 Darkbloom 最直接的加密赛道对手。Darkbloom 该模型报价更低(0.067 美元对比 0.155 美元),但 io.net 在延迟指标上占优(0.57 秒对比 2.05 秒)。
Darkbloom & Yukon:EigenCloud 的新基础组件
Darkbloom 与 Yukon 是 EigenCloud 的全新基础组件。EigenCloud 前身为 Eigenlayer,开创了再质押赛道,如今将重心转向 AI 推理与算力赛道。
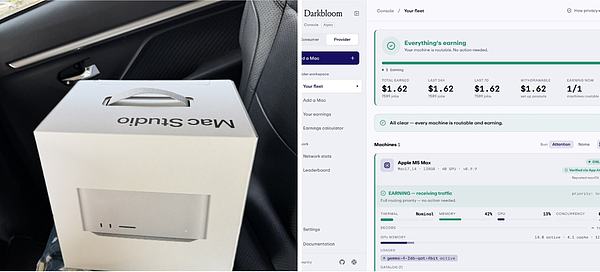
Darkbloom 是一套加密推理网络:除用户实际调用付费外无额外补贴;硬件不和竞争对手共享;需求侧计费统计由中立计量系统完成。Darkbloom 以现金报酬调度 1143 台 Mac 设备提供推理。Apple Silicon Mac 对比 GPU 存在性能局限,现阶段仅可运行参数量更小、成本更低的模型,Darkbloom 正在该细分赛道建立差异化优势。
对于 Darkbloom 所服务的模型,主要竞争者均为中心化托管服务商。虽然 Darkbloom 报价更低,但整体延迟偏高,导致 OpenRouter 平台的任务调度会较少分配流量给它。
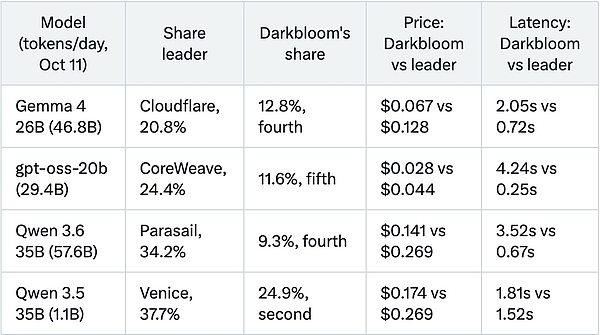
Darkbloom 在通义千问 Qwen 3.5 35B 模型上拿到了最高流量占比,该场景下它的延迟与头部服务商差距最小。在其余模型上,它的响应速度比行业领先者慢 3 至 17 倍,仅能获取约十分之一的流量。
Yukon 于 2026 年 8 月 12 日上线,是一个开源的“自动研究”平台:任何人都可以让人类研究者或 AI 智能体针对基准测试开展优化,经过验证的性能改进会合并至共享代码库,成为新的基准版本。它和 Darkbloom 存在紧密关联:其 MLX.fast 赛道要求开发者基于 Darkbloom 算力节点所使用的同一套 MLX Swift 技术栈,提升开源模型在苹果硅芯片上的运行速度。
MLX.fast 当中有三款模型正是 Darkbloom 对外提供服务的模型:
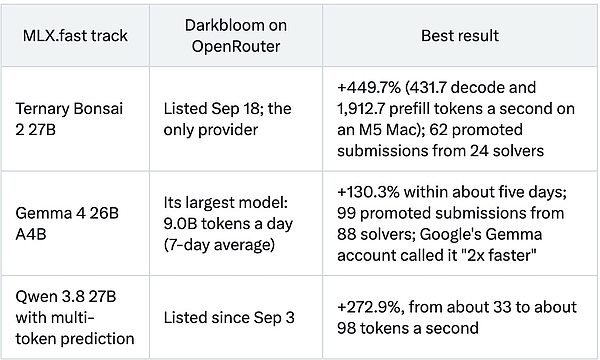
对 Darkbloom 而言,这相当于无需自建实验室即可获取研发成果。在不新增硬件的前提下,Mac 设备解码速度提升,单台机器便可处理更多 Token,算力运营方也能获得更高收益。这也是解决 Darkbloom 当前因延迟、吞吐量短板流失流量最直接的路径。
值得注意的是,Yukon 并非仅供 Darkbloom 使用:平台举办多场竞赛,最新的 hashmash 竞赛主要针对传统密码学安全开展压力测试与优化。未来或许会有更多企业效仿 Darkbloom,借助 Yukon 实现前沿技术突破。尽管 Darkbloom 正在为 EigenCloud 带来持续增长的手续费收入,但 Yukon 该如何捕获价值、并将收益传导至 EIGEN 代币,目前尚不明确。
量化代币激励的实际作用
本篇所分析的绝大多数网络,并不会完全依靠用户付费来覆盖供给侧或需求侧的部分成本。为便于横向对比,研究将各类激励的年度规模与用户付费年收入做对标,并按照激励接收方进行分类:
面向 GPU 供给方的代币激励:发放给硬件运营者。该激励保障算力持续在线,也使得网络可以做到定价低于硬件实际成本。
面向用户与质押者的代币激励:用来换取用户使用与用户忠诚度;GPU 硬件本身依旧以现金结算报酬。
面向供给方的现金奖励:在用户付费之外,额外向算力运营商发放美元现金补贴。
结论
加密 AI 推理赛道在整个推理市场中体量尚小,但处于增长阶段。该领域内,多家服务商正在尝试不同技术路线与实验方案,各家的商业模式差异巨大。
Venice 在一众项目中营收最高,但其收入主要来自自有面向消费者的应用;接入 OpenRouter 的目的是扩大曝光,而非赚取收益。它还从第三方采购算力,同时转售 NEAR AI 与 Phala 的算力来支撑自身隐私专属服务层级。
Phala 正越来越偏向扮演机密算力路由的角色,其在 OpenRouter 上的绝大部分流量实际跑在其他服务商的硬件之上,并依靠激励机制对供给侧进行补贴。Chutes 与 AkashML 售卖分布式 GPU 网络的算力资源。Chutes 的低价策略仍高度依赖 Bittensor 的代币释放补贴,而 Akash 的 GPU 激励已于 2025 年终止。
Darkbloom 是唯一采用消费级硬件对外提供推理服务的服务商,同时也是唯一一个拥有独立开源研发分支的项目。研究称,会持续跟踪该赛道,并把分析范围拓展至不在 OpenRouter 上架的其他推理服务商。目前尚不能确定加密赛道是否具备独特护城河以赢得市场竞争,但各类试验与创新具备发展潜力,行业竞赛已经正式开启。